过去几年登上头条的多数人工智能系统,其工作方式是预测下一段数据。语言模型预测下一个词。图像生成器预测像素。这个思路取得了惊人的成功, 但领域中最具影响力的研究者之一认为它存在上限, 而要构建真正理解世界的机器, 需要一种不同的想法.
这个想法叫联合嵌入预测架构, 或 JEPA。Yann LeCun 在 2022 年提出, 它是一种学习方式, 预测的是意义的抽象空间, 而不是像素或词的原始空间。其背后的押注很大, 即预测某件事的含义, 同时忽略那些无法被预测的细节, 更接近人类和动物的学习方式, 也比预测数据的每一个细节更适合作为推理和规划的基础。本指南深入探讨, 它解释 JEPA 是什么, 背后的能量型思想, 实际的训练目标, 从 I-JEPA 到 V-JEPA 2 的真实模型如何构建, 一个 JEPA 如何用于规划和行动, 它在更大的机器智能蓝图中处于何处, 以及为什么如今有一百亿美元的新融资正在押注在它身上.
JEPA 一分钟速览, 简短答案
联合嵌入预测架构 (JEPA) 是一种自监督学习方法, 它预测输入中某一部分的抽象表示, 而不是重建原始数据。通过预测意义而不是像素, 它可以忽略无法预测的细节, 并专注于关键结构。Yann LeCun 在 2022 年提出它, 作为迈向能够构建世界内部模型的 AI 的一步.
要点:
- JEPA 在表征空间中进行预测, 即嵌入空间, 而不是在输入空间中预测, 即像素或 token 空间.
- 这让它可以丢弃无法预测的噪声, 并学习高效且有意义的特征.
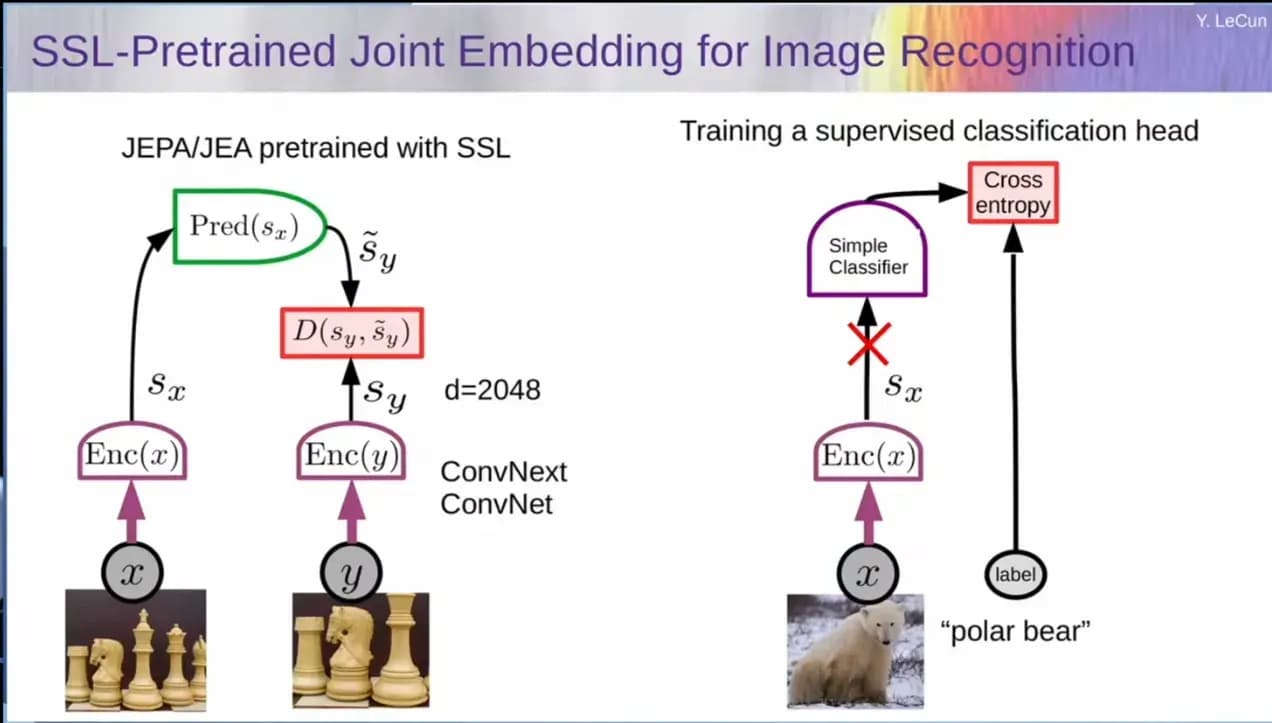
- 它使用编码器把输入变成嵌入, 再用预测器估计目标嵌入, 同时引入潜变量来处理无法已知的部分.
- 它是非生成式的, 它从不产生像素或文本, 只产生关于表征的预测.
- 主要模型包括 I-JEPA (图像, 2023)、V-JEPA (视频, 2024) 和 V-JEPA 2 (一种用于机器人规划的视频世界模型, 2025).
- JEPA 是世界模型的基础, 也是 LeCun 和他人所相信的, 通往超越当今大型语言模型之路的路径.
什么是联合嵌入预测架构?
名字听起来吓人, 但每个词都在描述这个想法中的一部分, 并且这些部分本身都很简单。联合嵌入意味着它把输入的两部分都转换为嵌入, 嵌入是紧凑的数字列表, 用来捕捉输入的含义或特征, 而不是它的原始外观。预测意味着它从另一部分去预测其中一个嵌入。架构只是指一种通用设计, 而不是单一模型.
合在一起, 一个 JEPA 会接收两个相关的输入, 通常是同一张图像的两部分, 或同一段视频的两个时刻, 然后通过预测一部分的嵌入如何从另一部分的嵌入中产生来学习。关键在于, 它从不尝试重建原始像素。它完全在表征的抽象空间中工作。这就是人们说 JEPA 在潜空间中进行预测时所指的内容。
它属于一种叫作自监督学习的家族, 在这种学习中, 模型通过隐藏输入的一部分并尝试用剩余部分去预测它来“自我教学”。不需要人类标注, 只需要原始图像、视频或其他信号。JEPA 在这个家族中与众不同之处在于, 它选择预测的是表征, 而不是数据本身。
为什么预测像素是错误目标
要理解为什么 JEPA 会出现, 需要看看它之前发生了什么。生成式模型通过尝试复现数据来学习。隐藏图像的一部分, 让它去填补完全缺失的像素, 或给它一句话, 让它生成下一个确切的词。问题在于, 世界充满了无法被精确预测的细节。
想象一段视频, 一个球向桌子边缘滚去。你可以有把握地预测, 它会掉下去。你无法预测的是它具体如何弹跳, 地板上的光线精确图案, 或空气中每一粒灰尘的精确位置。被迫去预测像素的模型, 必须把精力用在所有这些无法预测的细节上, 这会浪费它的容量在噪声上, 而不是在真正重要的事情上, 即球会掉下去。
JEPA 的回答是停止预测细节。它不再预报未来帧的每个像素, 而是预报它的抽象表征, 一种总结, 既能捕捉“球会掉下去”, 又能丢弃那些不可能已知的部分。编码器被允许丢掉无法预测的信息, 于是预测问题变得更容易, 它学到的特征也更有意义。这个单一变化, 从预测数据到预测表征, 正是 JEPA 的核心。
把 JEPA 看作能量型模型
LeCun 将 JEPA 放进一个更广泛的概念里, 叫作能量型模型, 而这种表述解释了其设计的很多部分。能量型模型不会直接输出概率或标签。相反, 它学习一个能量函数, 给“能彼此契合”的组合一个低值, 给“不契合”的组合一个高值。对于一对输入 x 和 y, 当 y 是 x 的合理搭档或延续时, 能量就很低, 当不是时能量就很高。
在 JEPA 中, 这种能量就是嵌入空间中的预测误差, 即预测得到的目标嵌入与真实目标嵌入之间的距离。当模型预测得好时, 能量就低, 这个配对就被判断为兼容。训练就是在这片地形上“雕刻”出山谷, 使得正确的配对落在底部, 错误的则被推到更高的位置。
用这种方式来看, collapse 问题就有了清晰的含义。如果编码器对所有输入都输出同一个向量, 那么地形会处处变平且能量都很低, 这没有用, 因为任何东西都无法与别的东西区分开来。训练一个 JEPA 的整个工艺, 就是在那些应该低的地方才让能量表面变低, 而后面描述的技术, 正是为了防止这片表面变平。
JEPA 如何工作, 架构内部
一个 JEPA 有三个主要部分, 最容易理解它们的方法, 就是把一个单独的训练示例沿着系统走一遍。