Phần lớn các hệ thống AI từng gây chú ý trong vài năm qua hoạt động bằng cách dự đoán dữ liệu tiếp theo. Một mô hình ngôn ngữ dự đoán từ tiếp theo. Một bộ tạo ảnh dự đoán các điểm ảnh. Cách tiếp cận này đã thành công một cách đáng kinh ngạc, nhưng một trong những nhà nghiên cứu có ảnh hưởng nhất trong lĩnh vực lập luận rằng nó có một trần giới hạn, và rằng cần một ý tưởng khác để xây dựng những cỗ máy thực sự hiểu thế giới.
Ý tưởng đó là Kiến trúc Dự đoán Khớp Nối Nhúng, hay JEPA. Được Yann LeCun đề xuất vào năm 2022, đây là một cách học dự đoán trong không gian trừu tượng của ý nghĩa, thay vì trong không gian thô của các điểm ảnh hoặc từ ngữ. Cược đằng sau nó là rất lớn, rằng việc dự đoán thứ gì đó có nghĩa là gì, trong khi bỏ qua các chi tiết không thể dự đoán được, gần hơn với cách con người và động vật học, và là nền tảng tốt hơn cho suy luận và lập kế hoạch so với việc dự đoán mọi chi tiết của dữ liệu. Hướng dẫn này đi sâu. Nó giải thích JEPA là gì, ý tưởng dựa trên năng lượng đằng sau nó, mục tiêu huấn luyện thực tế, cách các mô hình I-JEPA đến V-JEPA 2 được xây dựng, cách một JEPA được dùng để lập kế hoạch và hành động, nơi nó phù hợp trong một bản thiết kế lớn hơn cho trí tuệ máy móc, và vì sao hiện nay một tỷ đô la tiền tài trợ mới đang đặt cược vào nó.
JEPA trong một phút: câu trả lời ngắn
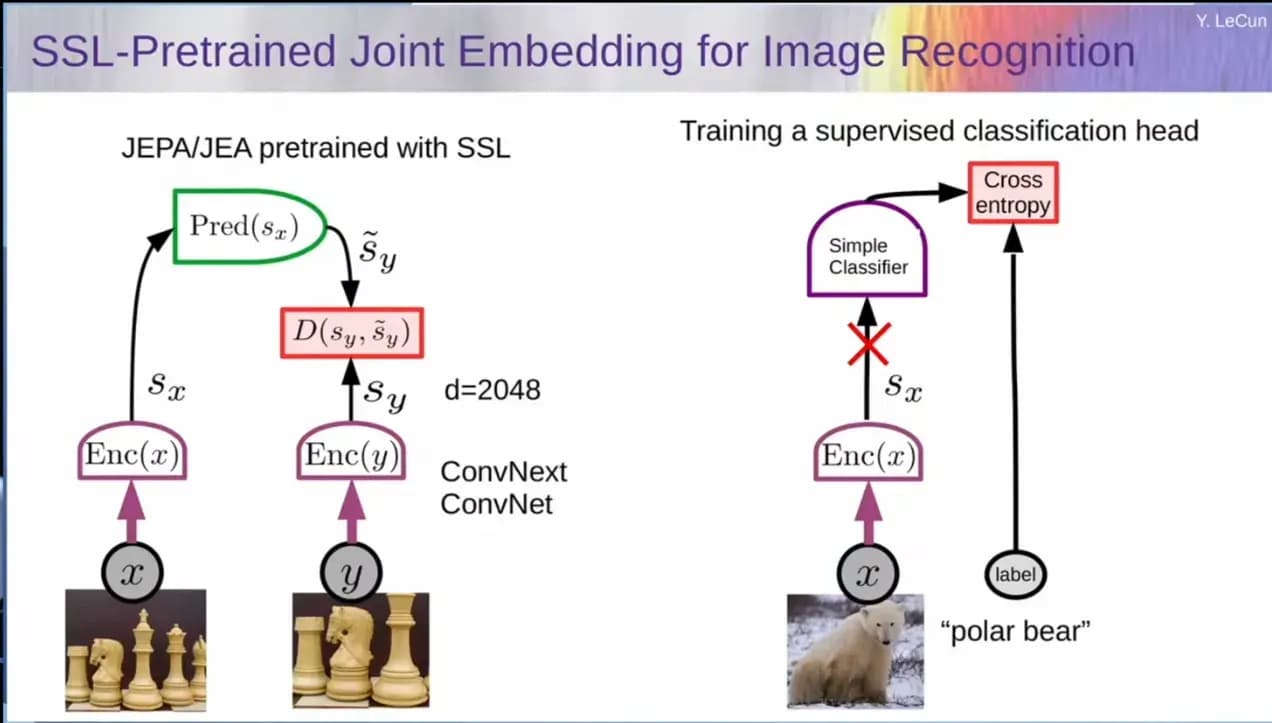
Kiến trúc Dự đoán Khớp Nối Nhúng chung (JEPA) là một phương pháp học tự giám sát, dự đoán biểu diễn trừu tượng của một phần đầu vào từ biểu diễn của một phần khác, thay vì tái tạo dữ liệu thô. Bằng cách dự đoán ý nghĩa thay vì điểm ảnh, nó có thể bỏ qua chi tiết không thể dự đoán và tập trung vào cấu trúc quan trọng. Yann LeCun đề xuất nó vào năm 2022 như một bước hướng tới AI xây dựng một mô hình nội bộ về thế giới.
Những điểm chính:
- JEPA dự đoán trong không gian biểu diễn, không gian của các nhúng, chứ không dự đoán trong không gian đầu vào, không gian của các điểm ảnh hay các token.
- Điều này cho phép nó loại bỏ nhiễu không thể dự đoán và học các đặc trưng hiệu quả, giàu ý nghĩa.
- Nó dùng một bộ mã hóa để biến đầu vào thành các nhúng và một bộ dự đoán để ước lượng nhúng mục tiêu, với một biến ẩn để xử lý những gì không thể biết được.
- Nó không sinh ra dữ liệu: nó không bao giờ tạo ra điểm ảnh hay chữ, chỉ tạo ra các dự đoán về biểu diễn.
- Các mô hình chính gồm I-JEPA (ảnh, 2023), V-JEPA (video, 2024), và V-JEPA 2 (một mô hình thế giới video dùng cho lập kế hoạch của robot, 2025).
- JEPA là nền tảng của các mô hình thế giới mà LeCun và những người khác tin rằng đó là con đường vượt ra khỏi các mô hình ngôn ngữ lớn ngày nay.
Kiến trúc Dự đoán Khớp Nối Nhúng là gì?
Tên gọi nghe đáng sợ, nhưng mỗi từ trong đó mô tả một phần đơn giản của ý tưởng. Khớp nối nhúng chung nghĩa là nó biến hai phần đầu vào thành các nhúng, là những danh sách gọn của các con số nắm bắt ý nghĩa hoặc các đặc trưng của đầu vào, thay vì hình ảnh thô của nó. Dự đoán nghĩa là nó dự đoán một trong các nhúng đó từ cái còn lại. Kiến trúc chỉ có nghĩa là đó là một thiết kế tổng quát, không phải là một mô hình đơn lẻ.
Ghép lại với nhau, một JEPA nhận hai đầu vào liên quan với nhau, thường là hai phần của cùng một ảnh, hoặc hai khoảnh khắc của cùng một video, và học bằng cách dự đoán nhúng của một phần từ nhúng của phần kia. Quan trọng là, nó không bao giờ cố tái tạo lại các điểm ảnh gốc. Nó hoạt động hoàn toàn trong không gian trừu tượng của biểu diễn. Đây là điều mọi người muốn nói khi nói rằng JEPA dự đoán trong không gian tiềm ẩn.
Nó thuộc một họ được gọi là học tự giám sát, trong đó một mô hình tự dạy mình từ dữ liệu không gắn nhãn bằng cách che một phần đầu vào và cố gắng dự đoán nó từ phần còn lại. Không cần nhãn từ con người, chỉ cần các ảnh thô, video, hoặc các tín hiệu khác. Điều làm cho JEPA khác biệt trong nhóm đó là quyết định dự đoán biểu diễn thay vì bản thân dữ liệu.
Vì sao dự đoán các điểm ảnh là mục tiêu sai
Để thấy vì sao JEPA tồn tại, hãy nhìn vào những gì đã đến trước nó. Một mô hình sinh tạo học bằng cách cố tái tạo dữ liệu. Che một phần của ảnh và yêu cầu nó điền vào đúng các điểm ảnh còn thiếu, hoặc đưa cho nó một câu và yêu cầu nó tạo ra đúng từ tiếp theo. Vấn đề là thế giới đầy rẫy các chi tiết không thể dự đoán chính xác.
Hãy tưởng tượng một video cho thấy một quả bóng lăn về phía mép bàn. Bạn có thể dự đoán một cách tự tin rằng nó sẽ rơi. Nhưng thứ bạn không thể dự đoán là cách nó nảy chính xác, mẫu ánh sáng chính xác trên sàn, hay vị trí của mọi hạt bụi li ti trong không khí. Một mô hình bị ép phải dự đoán các điểm ảnh phải dành nỗ lực của mình để chốt tất cả các chi tiết không thể dự đoán đó, điều này làm lãng phí năng lực cho nhiễu thay vì vào điều quan trọng, đó là quả bóng rơi.
Câu trả lời của JEPA là dừng việc dự đoán chi tiết. Thay vì dự đoán mọi điểm ảnh của khung hình tương lai, nó dự đoán một biểu diễn trừu tượng của khung đó, một bản tóm tắt có thể nắm bắt quả bóng sẽ rơi, đồng thời bỏ qua các phần không thể biết được. Bộ mã hóa được phép loại bỏ thông tin không thể dự đoán, nên bài toán dự đoán trở nên dễ hơn, và các đặc trưng mà nó học được trở nên có ý nghĩa hơn. Chỉ một thay đổi đó, từ dự đoán dữ liệu sang dự đoán biểu diễn, chính là trái tim của JEPA.
JEPA như một mô hình dựa trên năng lượng
LeCun đặt JEPA vào một ý tưởng rộng hơn gọi là mô hình dựa trên năng lượng, và cách đóng khung đó giải thích nhiều phần thiết kế của nó. Một mô hình dựa trên năng lượng không xuất ra xác suất hay nhãn trực tiếp. Thay vào đó, nó học một hàm năng lượng gán giá trị thấp cho các tổ hợp khớp với nhau, và giá trị cao cho các tổ hợp không khớp. Với một cặp đầu vào x và y, năng lượng thấp khi y là một “đối tác” hay “sự tiếp diễn” hợp lý của x, và năng lượng cao khi điều đó không đúng.
Trong JEPA, năng lượng đó chính là sai số dự đoán trong không gian biểu diễn, tức khoảng cách giữa nhúng mục tiêu được dự đoán và nhúng mục tiêu thật. Khi mô hình dự đoán tốt, năng lượng thấp, và cặp đó được xem là tương thích. Việc huấn luyện là hành động “khắc” các thung lũng vào cảnh quan này xung quanh dữ liệu thật, sao cho các cặp đúng nằm ở đáy, còn các cặp sai bị đẩy lên phía trên.
Nhìn theo cách này, vấn đề sụp đổ có một ý nghĩa rõ ràng. Nếu bộ mã hóa xuất ra cùng một vectơ cho mọi thứ, thì cảnh quan sẽ phẳng và thấp ở khắp nơi, điều đó là vô dụng vì không có gì được phân biệt với bất kỳ thứ gì khác. Công phu toàn bộ của việc huấn luyện một JEPA là tạo hình một bề mặt năng lượng thấp chỉ tại nơi nó nên thấp, và các kỹ thuật được mô tả sau tồn tại chính xác để ngăn bề mặt đó bị phẳng.