La plupart des systèmes d'IA qui ont fait la une ces dernières années fonctionnent en prédisant la prochaine portion de données. Un modèle de langage prédit le prochain mot. Un générateur d'images prédit des pixels. Cette approche a été étonnamment efficace, mais l'un des chercheurs les plus influents du domaine soutient qu'elle atteint un plafond, et qu'une idée différente est nécessaire pour construire des machines qui comprennent vraiment le monde.
Cette idée, c'est l'architecture conjointe d'embedding prédictif, ou JEPA. Proposée par Yann LeCun en 2022, c'est une façon d'apprendre qui prédit dans un espace abstrait de sens plutôt que dans l'espace brut des pixels ou des mots. Le pari qui la sous-tend est de taille, prédire ce que quelque chose signifie, tout en ignorant les détails qui ne peuvent pas être prédits, se rapproche de la façon dont les humains et les animaux apprennent, et constitue une meilleure base pour raisonner et planifier que de prédire chaque détail des données. Ce guide plonge en profondeur. Il explique ce qu'est la JEPA, l'idée basée sur l'énergie qui la sous-tend, l'objectif d'entraînement réel, comment les modèles concrets, de I-JEPA à V-JEPA 2, sont construits, comment une JEPA est utilisée pour planifier et agir, où elle s'inscrit dans une feuille de route plus large pour l'intelligence des machines, et pourquoi un milliard de dollars de nouveau financement est aujourd'hui mis en jeu.
JEPA en une minute, la réponse courte
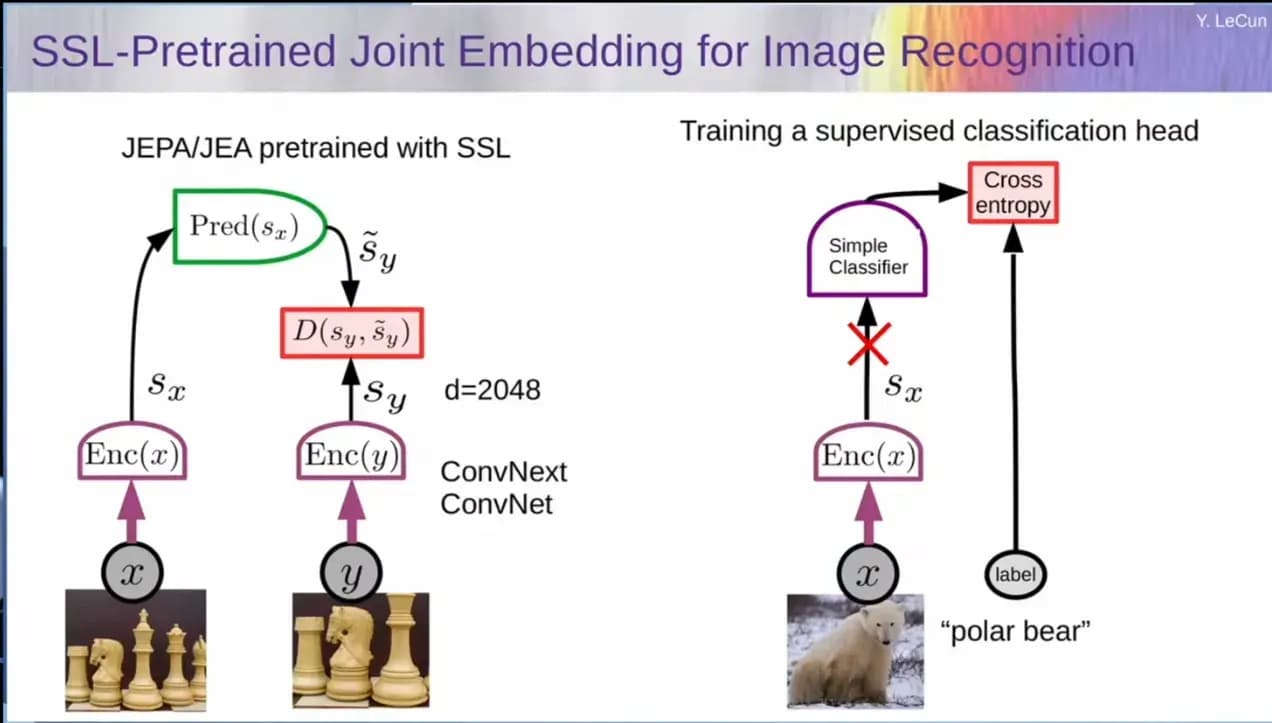
Une architecture conjointe d'embedding prédictif (JEPA) est une méthode d'apprentissage auto-supervisé qui prédit la représentation abstraite d'une partie d'une entrée à partir de la représentation d'une autre partie, au lieu de reconstruire les données brutes. En prédisant le sens plutôt que les pixels, elle peut ignorer les détails imprévisibles et se concentrer sur la structure qui compte. Yann LeCun l'a proposée en 2022 comme une étape vers une IA qui construit un modèle interne du monde.
Points clés :
- La JEPA prédit dans l'espace des représentations, l'espace des embeddings, pas dans l'espace d'entrée, l'espace des pixels ou des tokens.
- Cela lui permet d'écarter le bruit imprévisible et d'apprendre des caractéristiques efficaces et significatives.
- Elle utilise un encodeur pour transformer les entrées en embeddings, et un prédicteur pour estimer un embedding cible, avec une variable latente pour gérer ce qui ne peut pas être connu.
- Elle est non générative, elle ne produit jamais de pixels ni de texte, seulement des prédictions concernant des représentations.
- Les principaux modèles sont I-JEPA (images, 2023), V-JEPA (vidéo, 2024), et V-JEPA 2 (un modèle du monde vidéo utilisé pour la planification robotique, 2025).
- La JEPA est le fondement des modèles du monde que LeCun et d'autres pensent être la voie au-delà des grands modèles de langage d'aujourd'hui.
Qu'est-ce qu'une architecture conjointe d'embedding prédictif ?
Le nom intimide, mais chaque mot décrit une partie simple de l'idée. « Embedding conjoint » signifie qu'elle transforme deux portions d'entrée en embeddings, qui sont des listes compactes de nombres capturant la signification ou les caractéristiques de l'entrée plutôt que son apparence brute. « Prédictif » signifie qu'elle prédit l'une de ces embeddings à partir de l'autre. « Architecture » indique simplement qu'il s'agit d'un design général, pas d'un unique modèle.
Assemblée, une JEPA prend deux entrées liées, souvent deux parties de la même image ou deux instants de la même vidéo, et apprend en prédisant l'embedding d'une partie à partir de l'embedding de l'autre. Crucialement, elle n'essaie jamais de recréer les pixels originaux. Elle fonctionne entièrement dans l'espace abstrait des représentations. C'est ce que les gens veulent dire quand ils disent que la JEPA prédit dans l'espace latent.
Elle appartient à une famille appelée apprentissage auto-supervisé, où un modèle s'enseigne à partir de données non étiquetées en cachant une partie de l'entrée et en essayant de la prédire à partir du reste. Aucune étiquette humaine n'est nécessaire, seulement des images brutes, de la vidéo, ou d'autres signaux. Ce qui rend la JEPA distincte dans cette famille, c'est la décision de prédire des représentations plutôt que les données elles-mêmes.
Pourquoi prédire des pixels est un objectif erroné
Pour comprendre pourquoi la JEPA existe, regardez ce qui est venu avant. Un modèle génératif apprend en essayant de reproduire les données. Cachez une partie d'une image et demandez-lui de remplir exactement les pixels manquants, ou donnez-lui une phrase et demandez le prochain mot exact. Le problème, c'est que le monde est rempli de détails qui ne peuvent pas être prédits exactement.
Imaginez une vidéo d'une balle roulant vers le bord d'une table. Vous pouvez prédire avec confiance qu'elle tombera. Ce que vous ne pouvez pas prédire, c'est la manière précise dont elle rebondira, le motif exact de la lumière sur le sol, ou la position de chaque particule de poussière dans l'air. Un modèle forcé à prédire des pixels doit consacrer ses efforts à tous ces détails imprévisibles, ce qui gaspille sa capacité au lieu de la consacrer à ce qui compte, à savoir que la balle tombe.
La réponse de la JEPA consiste à cesser de prédire les détails. Au lieu de prévoir chaque pixel de la future image, elle prévoit une représentation abstraite, un résumé qui peut capter que la balle tombe tout en écartant les parties impossibles à connaître. L'encodeur est autorisé à supprimer les informations imprévisibles, ce qui rend le problème de prédiction plus facile, et les caractéristiques qu'il apprend deviennent plus significatives. Ce changement unique, de la prédiction des données à la prédiction des représentations, est le cœur de la JEPA.
JEPA comme modèle basé sur l'énergie
LeCun inscrit la JEPA dans une idée plus large appelée modèle basé sur l'énergie, et cette mise en cadre explique une grande partie de sa conception. Un modèle basé sur l'énergie ne produit pas directement une probabilité ou une étiquette. Au lieu de cela, il apprend une fonction d'énergie qui attribue une faible valeur aux combinaisons qui s'accordent et une forte valeur aux combinaisons qui ne s'accordent pas. Pour un couple d'entrées x et y, l'énergie est faible lorsque y est un partenaire plausible ou une continuation de x, et élevée lorsque ce n'est pas le cas.
Dans une JEPA, cette énergie est l'erreur de prédiction dans l'espace des embeddings, la distance entre l'embedding cible prédit et le vrai. Lorsque le modèle prédit bien, l'énergie est faible, et le couple est jugé compatible. L'entraînement consiste à creuser des vallées dans ce paysage autour des vraies données, de sorte que les bons appariements se trouvent tout en bas et que les mauvais soient poussés vers le haut.
Vue ainsi, la question de l'effondrement (collapse) prend un sens clair. Si l'encodeur produit le même vecteur pour tout, le paysage devient plat et faible partout, ce qui est inutile, car rien n'est distingué du reste. Tout le travail d'entraînement d'une JEPA consiste à façonner une surface d'énergie faible uniquement là où il faut, et les techniques décrites plus loin existent précisément pour empêcher cette surface de devenir plate.
Comment fonctionne la JEPA, à l'intérieur de l'architecture
Une JEPA comporte trois parties principales, et la façon la plus simple de les comprendre est de suivre un seul exemple d'entraînement à travers le système.