ここ数年で話題になった大半のAIシステムは、次に来るデータを予測することで動作します。言語モデルは次の単語を予測します。画像生成器はピクセルを予測します。このアプローチは驚異的な成功を収めてきましたが、分野で最も影響力のある研究者の一人は、この方法には上限があり、世界を本当に理解する機械を作るには別の発想が必要だと主張しています。
その発想が、Joint Embedding Predictive Architecture、JEPAです。2022年にYann LeCunによって提案されたもので、生のピクセルや単語の空間ではなく、意味の抽象空間の中で予測する学習方法です。狙いは大きくあります。予測できない細部を無視しつつ、何かが持つ意味を予測することは、人間や動物が学ぶ仕組みにより近く、データの細部をすべて予測するよりも、推論や計画のより良い基盤になるという賭けです。このガイドは深掘りします。JEPAが何か、そこにあるエネルギーベースの考え方、実際の学習目的、I-JEPAからV-JEPA 2までの実モデルがどのように作られるか、JEPAが計画と行動にどう使われるか、大きな機械知能の設計図の中でどこに位置づくか、そしてなぜ今その上に10億ドル規模の新たな資金が投じられているのかを説明します。
JEPAを1分で: 短い答え
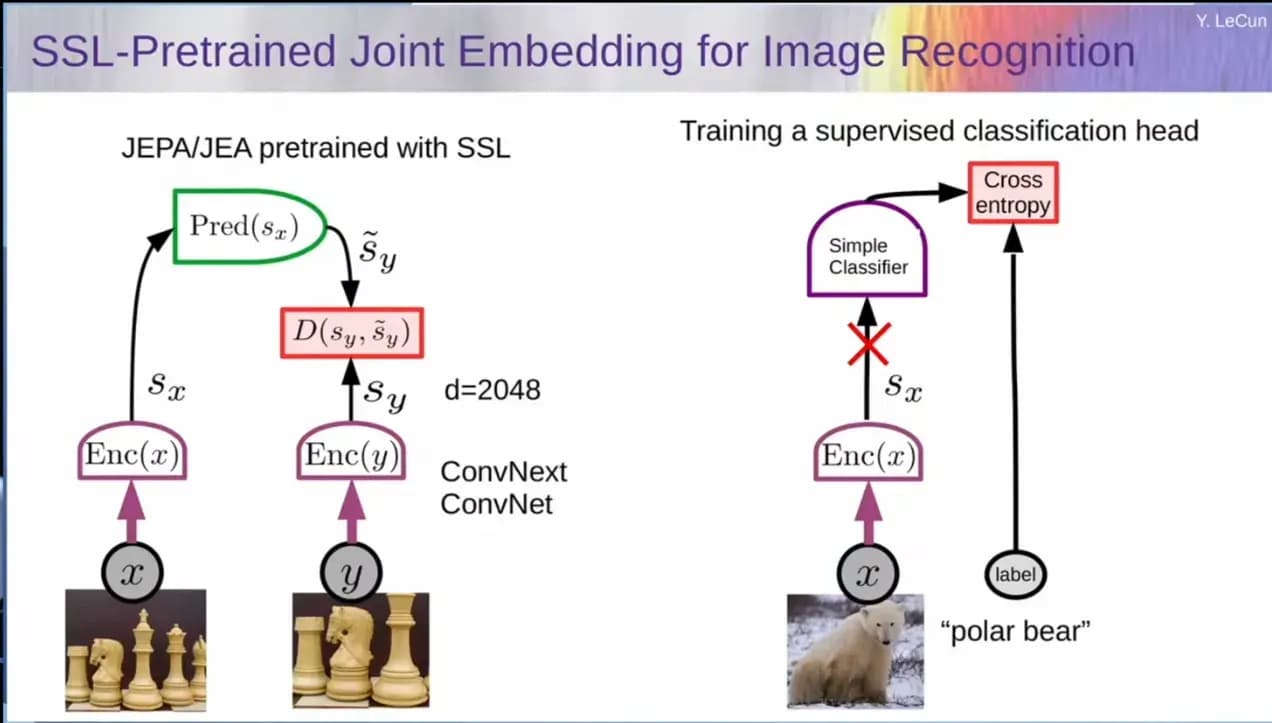
Joint Embedding Predictive Architecture (JEPA)は、自教師あり学習の一手法であり、入力の一部の抽象的な表現を、別の一部の表現から予測します。生データを復元するのではありません。ピクセルではなく意味を予測することで、予測できない細部を無視し、重要な構造に集中できます。Yann LeCunは2022年に、それを、世界の内部モデルを構築するAIへの一歩として提案しました。
要点:
- JEPAは入力空間ではなく表現空間、埋め込み(embedding)の空間で予測します。入力空間はピクセルやトークンの空間です。
- これにより、予測できないノイズを捨て、効率的で意味のある特徴を学習できます。
- エンコーダを使って入力を埋め込みに変換し、潜在変数を使って知り得ない部分を扱いながら、予測器が目標となる埋め込みを推定します。
- 非生成的です。ピクセルやテキストは生成せず、表現に関する予測だけを行います。
- 主要なモデルは、I-JEPA(画像, 2023)、V-JEPA(動画, 2024)、およびV-JEPA 2(ロボットの計画に使われる動画の世界モデル, 2025)です。
- JEPAは、LeCunや他の研究者が「今日の大規模言語モデルの先」を実現する道だと考える世界モデルの土台です。
Joint Embedding Predictive Architectureとは?
名前は一見難しそうですが、各語がアイデアの単純な部分を説明しています。Joint embeddingは、入力を2つの要素に対して埋め込みに変換することを意味します。埋め込みとは、入力そのものの生の見た目ではなく、その意味や特徴を捉える、コンパクトな数のリストです。Predictiveは、その埋め込みの1つを別のものから予測することを意味します。Architectureは、単一のモデルではなく一般的な設計であるという意味です。
まとめると、JEPAは互いに関連した2つの入力を取り、しばしば同じ画像の2つの部分、あるいは同じ動画の2つの時点として、それらのうちの1つの部分の埋め込みを、もう一方の埋め込みから予測することで学習します。重要なのは、元のピクセルを再現しようと決してしないことです。表現の抽象空間だけで動作します。人々が「JEPAは潜在空間で予測する」と言うときに意味しているのはこれです。
JEPAは、自教師あり学習と呼ばれる系統に属します。そこでは、入力の一部を隠して残りから予測することで、ラベルなしデータからモデル自身が学習します。人間のラベルは不要で、必要なのは生の画像、動画、または他の信号だけです。その系統の中でJEPAを特徴づけるのは、データそのものではなく表現を予測するという判断です。
ピクセルを予測することが間違った目標な理由
JEPAがなぜ存在するのかを見るには、前に何があったかを見ればよいです。生成モデルはデータを再現しようとすることで学びます。画像の一部を隠して、正確に欠けたピクセルを埋めるよう求めるか、文章を与えて「次の正確な単語」を求めます。問題は、世界には、完全に正確には予測できない細部があふれていることです。
テーブルの端に向かって転がっていくボールの動画を想像してください。落ちるだろうことは確信を持って予測できます。しかし予測できないのは、跳ね方の正確な仕方、床に当たる光の正確な模様、空気中のあらゆる微粒子の位置です。ピクセルを予測するよう強制されたモデルは、こうした予測できない細部をすべて当てるのに努力を費やさなければならず、それは意味のある「ボールが落ちる」という本質の代わりにノイズへと計算資源を浪費します。
JEPAの答えは細部を予測するのをやめることです。未来のフレームのすべてのピクセルを予測する代わりに、それの抽象的な表現を予測します。それは、ボールが落ちることを捉えながら、知りようのない部分を捨てられる要約です。エンコーダは予測できない情報を落としてよいので、予測問題がより簡単になり、学習される特徴がより意味のあるものになります。データを予測することから表現を予測することへのこの1つの変更こそが、JEPAの核心です。
エネルギーベースモデルとしてのJEPA
LeCunはJEPAを、より広い考え方である「エネルギーベースモデル」の中に位置づけます。この枠組みが、その設計の多くを説明してくれます。エネルギーベースモデルは、確率やラベルを直接出力しません。代わりに、一致する組み合わせには低い値を、そうでない組み合わせには高い値を返すエネルギー関数を学習します。入力xとyの組に対して、yがxのもっともらしい相手や継続であるときエネルギーは低くなり、そうでなければ高くなります。
JEPAにおいてそのエネルギーは、埋め込み空間での予測誤差です。つまり、予測された目標埋め込みと実際の埋め込みの距離です。モデルがうまく予測できているとき、エネルギーは低くなり、組は適合と判断されます。学習とは、この風景の中で実データの周りに谷を彫り込む行為です。正しい組み合わせは底に置かれ、間違った組は押し上げら