La mayoría de los sistemas de IA que han acaparado titulares en los últimos años funcionan prediciendo la siguiente pieza de datos. Un modelo de lenguaje predice la siguiente palabra. Un generador de imágenes predice píxeles. Este enfoque ha sido sorprendentemente exitoso, pero uno de los investigadores más influyentes del campo sostiene que tiene un límite, y que hace falta una idea diferente para construir máquinas que realmente comprendan el mundo.
Esa idea es la Joint Embedding Predictive Architecture, o JEPA. Propuesta por Yann LeCun en 2022, es una forma de aprendizaje que predice en un espacio abstracto de significado, en lugar de hacerlo en el espacio sin procesar de píxeles o palabras. La apuesta detrás es grande: que predecir lo que algo significa, mientras se ignoran los detalles que no se pueden predecir, se parece más a cómo aprenden los humanos y los animales, y es una mejor base para razonar y planificar que predecir cada detalle de los datos. Esta guía profundiza. Explica qué es JEPA, la idea basada en energía que hay detrás, el objetivo real de entrenamiento, cómo se construyen los modelos reales de I-JEPA a V-JEPA 2, cómo se usa una JEPA para planificar y actuar, dónde encaja en un plano más amplio para la inteligencia de las máquinas, y por qué ahora un billón de dólares de nueva financiación va en su camino.
JEPA en un minuto: la respuesta corta
Una Joint Embedding Predictive Architecture (JEPA) es un método de aprendizaje auto supervisado que predice la representación abstracta de una parte de una entrada a partir de la representación de otra parte, en lugar de reconstruir los datos sin procesar. Al predecir significado en vez de píxeles, puede ignorar el detalle impredecible y centrarse en la estructura que importa. Yann LeCun la propuso en 2022 como un paso hacia una IA que construye un modelo interno del mundo.
Puntos clave:
- JEPA predice en el espacio de representaciones, el espacio de embeddings, no en el espacio de entrada, el espacio de píxeles o tokens.
- Esto le permite desechar el ruido impredecible y aprender características eficientes y significativas.
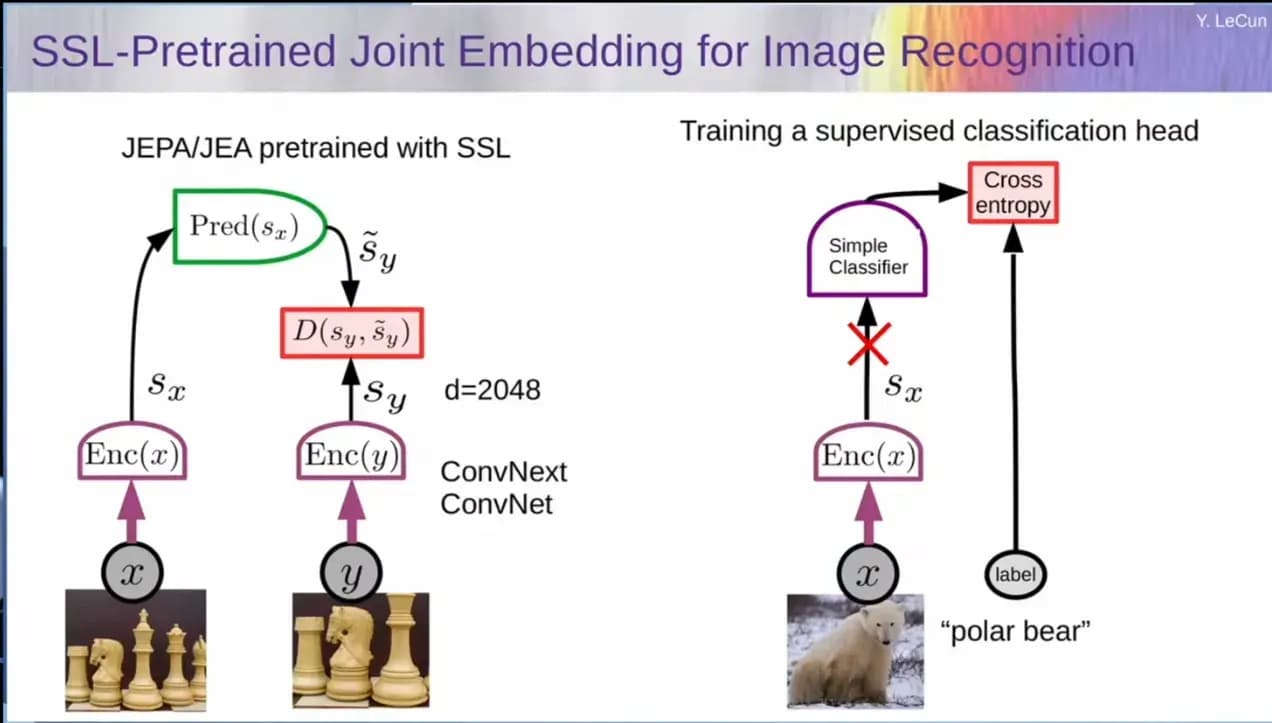
- Usa un codificador para convertir las entradas en embeddings y un predictor para estimar un embedding objetivo, con una variable latente para manejar lo que no se puede conocer.
- Es no generativa: nunca produce píxeles ni texto, solo predicciones sobre representaciones.
- Los modelos principales son I-JEPA (imágenes, 2023), V-JEPA (video, 2024), y V-JEPA 2 (un modelo de mundo de video usado para la planificación de robots, 2025).
- JEPA es la base de los modelos del mundo que LeCun y otros creen que es el camino más allá de los actuales grandes modelos de lenguaje.
¿Qué es una Joint Embedding Predictive Architecture?
El nombre intimida, pero cada palabra describe una parte sencilla de la idea. Joint embedding significa que convierte dos partes de la entrada en embeddings, que son listas compactas de números que capturan el significado o las características de la entrada en lugar de su apariencia sin procesar. Predictive significa que predice una de esas representaciones a partir de la otra. Architecture solo significa que es un diseño general, no un único modelo.
Juntas, una JEPA toma dos entradas relacionadas, a menudo dos partes de la misma imagen o dos momentos del mismo video, y aprende prediciendo el embedding de una parte a partir del embedding de la otra. Lo crucial es que nunca intenta recrear los píxeles originales. Funciona enteramente en el espacio abstracto de representaciones. Esto es lo que la gente quiere decir cuando dice que JEPA predice en espacio latente.
Pertenece a una familia llamada aprendizaje auto supervisado, en la que un modelo se enseña a sí mismo a partir de datos sin etiquetas, ocultando parte de la entrada y tratando de predecirla a partir del resto. No se necesitan etiquetas humanas, solo imágenes sin procesar, video u otras señales. Lo que hace distinta a JEPA dentro de esa familia es la decisión de predecir representaciones en vez de los datos en sí.
Por qué predecir píxeles es el objetivo equivocado
Para entender por qué existe JEPA, mira lo que vino antes. Un modelo generativo aprende intentando reproducir los datos. Oculta parte de una imagen y pídele que rellene los píxeles exactos que faltan, o dale una frase y pídele que produzca la siguiente palabra exacta. El problema es que el mundo está lleno de detalles que no se pueden predecir con exactitud.
Imagina un video de una pelota rodando hacia el borde de una mesa. Puedes predecir con confianza que caerá. Lo que no puedes predecir es la forma precisa en que rebotará, el patrón exacto de luz en el suelo, o la posición de cada mota de polvo en el aire. Un modelo obligado a predecir píxeles tiene que dedicar su esfuerzo a fijar todo ese detalle impredecible, lo que desperdicia su capacidad en ruido en lugar de en aquello que importa, que es que la pelota cae.
La respuesta de JEPA es dejar de predecir el detalle. En vez de pronosticar cada píxel del fotograma futuro, pronostica una representación abstracta del mismo, un resumen que puede capturar que la pelota cae y, al mismo tiempo, descarta las partes que es imposible conocer. Se permite que el codificador descarte información impredecible, por lo que el problema de predicción se vuelve más fácil y las características que aprende se vuelven más significativas. Este único cambio, de predecir datos a predecir representaciones, es el corazón de JEPA.
JEPA como modelo basado en energía
LeCun enmarca JEPA dentro de una idea más amplia llamada modelo basado en energía, y ese encuadre explica gran parte de su diseño. Un modelo basado en energía no produce una probabilidad ni una etiqueta directamente. En su lugar, aprende una función de energía que asigna un valor bajo a combinaciones que encajan y un valor alto a combinaciones que no lo hacen. Para un par de entradas x e y, la energía es baja cuando y es un socio o continuación plausible de x, y es alta cuando no lo es.
En una JEPA, esa energía es el error de predicción en el espacio de embeddings: la distancia entre el embedding objetivo predicho y el real. Cuando el modelo predice bien, la energía es baja, y el par se considera compatible. Entrenar es la acción de tallar valles en ese paisaje alrededor de los datos reales, de modo que las correspondencias correctas queden en el fondo y las incorrectas se empujen hacia arriba.
Visto así, el problema del colapso tiene un significado claro. Si el codificador produce el mismo vector para todo, el paisaje se vuelve plano y bajo en todas partes, lo cual es inútil porque nada se distingue de nada. Todo el oficio de entrenar una JEPA consiste en dar forma a una superficie de energía que sea baja solo donde debe, y las técnicas descritas más adelante existen precisamente para evitar que esa superficie se vuelva plana.
Cómo funciona JEPA, dentro de la arquitectura
Una JEPA tiene tres partes principales, y la forma más fácil de entenderlas es seguir un único ejemplo de entrenamiento a través del sistema.