ระบบ AI ส่วนใหญ่ที่ถูกพูดถึงในช่วงไม่กี่ปีที่ผ่านมา ทำงานโดยการคาดการณ์ข้อมูลชิ้นถัดไป ระบบภาษาคาดการณ์คำถัดไป ตัวสร้างภาพคาดการณ์พิกเซล แนวทางนี้ประสบความสำเร็จอย่างน่าทึ่ง แต่หนึ่งในนักวิจัยที่มีอิทธิพลมากที่สุดในสาขานี้ยืนยันว่ามีเพดาน และจำเป็นต้องมีความคิดที่ต่างออกไปเพื่อสร้างเครื่องจักรที่เข้าใจโลกอย่างแท้จริง
ความคิดนั้นคือ Joint Embedding Predictive Architecture หรือ JEPA เสนอโดย Yann LeCun ในปี 2022 เป็นวิธีการเรียนรู้ที่คาดการณ์ในพื้นที่เชิงนามธรรมของความหมาย แทนที่จะคาดการณ์ในพื้นที่ดิบของพิกเซลหรือคำ สิ่งที่เดิมพันไว้มีขนาดใหญ่ เพราะการคาดการณ์ว่าสิ่งหนึ่งมีความหมายว่าอย่างไร โดยละทิ้งรายละเอียดที่ไม่สามารถคาดการณ์ได้ เป็นสิ่งที่ใกล้เคียงกับวิธีที่มนุษย์และสัตว์เรียนรู้ และเป็นรากฐานที่ดีกว่าสำหรับการใช้เหตุผลและการวางแผน เมื่อเทียบกับการคาดการณ์รายละเอียดทุกอย่างของข้อมูล คู่มือนี้ลงลึก อธิบายว่า JEPA คืออะไร แนวคิดเชิงพลังงานที่อยู่เบื้องหลัง วัตถุประสงค์การฝึกจริง โมเดลที่เป็นตัวจริงตั้งแต่ I-JEPA ไปจนถึง V-JEPA 2 ถูกสร้างอย่างไร JEPA ถูกใช้เพื่อวางแผนและลงมือทำอย่างไร มันเข้าที่เข้าทางในพิมพ์เขียวที่ใหญ่กว่าสำหรับสติปัญญาของเครื่องจักรอย่างไร และเหตุใดเงินทุนใหม่มูลค่าหนึ่งพันล้านดอลลาร์จึงกำลังไหลไปรidingอยู่กับมัน
JEPA ในหนึ่งนาที: คำตอบสั้นๆ
Joint Embedding Predictive Architecture (JEPA) คือวิธีการเรียนรู้แบบกึ่งกำกับตนเอง (self-supervised learning) ที่คาดการณ์การแทนเชิงนามธรรมของส่วนหนึ่งของอินพุต จากการแทนของอีกส่วนหนึ่ง แทนที่จะสร้างข้อมูลดิบขึ้นมาใหม่ โดยการคาดการณ์ความหมายแทนที่จะคาดการณ์พิกเซล มันสามารถละทิ้งรายละเอียดที่คาดเดาไม่ได้ และโฟกัสเฉพาะโครงสร้างที่สำคัญ Yann LeCun เสนอมันในปี 2022 เพื่อเป็นก้าวสู่ AI ที่สร้างแบบจำลองภายในของโลก
ประเด็นสำคัญ:
- JEPA คาดการณ์ในพื้นที่ของการแทน (representation space) นั่นคือพื้นที่ของ embeddings ไม่ใช่ในพื้นที่อินพุต นั่นคือพื้นที่ของพิกเซลหรือโทเคน
- วิธีนี้ทำให้มันทิ้งสัญญาณรบกวนที่คาดเดาไม่ได้ และเรียนรู้คุณลักษณะที่มีความหมายได้อย่างมีประสิทธิภาพ
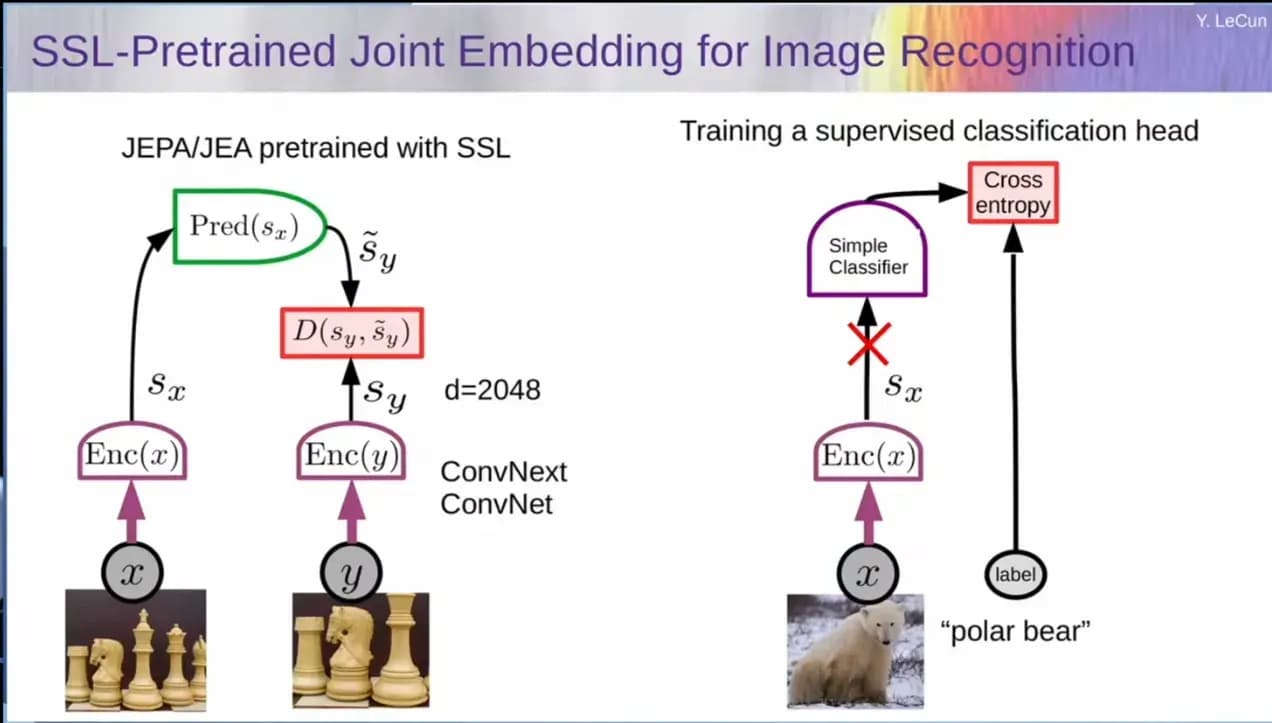
- มันใช้ตัวเข้ารหัส (encoder) เพื่อแปลงอินพุตเป็น embeddings และตัวทำนาย (predictor) เพื่อประมาณค่า embedding เป้าหมาย โดยมีตัวแปรแฝงเพื่อจัดการกับสิ่งที่ไม่สามารถรู้ได้
- มันเป็นแบบไม่สร้าง (non-generative) คือมันไม่เคยสร้างพิกเซลหรือข้อความ มีแต่การคาดการณ์เกี่ยวกับการแทนเท่านั้น
- โมเดลหลักคือ I-JEPA (ภาพ, 2023), V-JEPA (วิดีโอ, 2024), และ V-JEPA 2 (โมเดลโลกของวิดีโอที่ใช้สำหรับการวางแผนของหุ่นยนต์, 2025)
- JEPA คือรากฐานของ world models ที่ LeCun และคนอื่นๆ เชื่อว่าเป็นเส้นทางต่อไปจากโมเดลภาษาขนาดใหญ่ในปัจจุบัน
Joint Embedding Predictive Architecture คืออะไร
ชื่อดูน่ากลัว แต่แต่ละคำก็อธิบายส่วนที่เรียบง่ายของแนวคิด ทุกอย่างเกี่ยวกับ joint embedding คือการนำอินพุตสองส่วนมาแปลงเป็น embeddings ซึ่งเป็นรายการตัวเลขขนาดกะทัดรัดที่จับความหมายหรือคุณลักษณะของอินพุต แทนที่จะสะท้อนภาพดิบ Predictive หมายถึงคาดการณ์หนึ่งใน embeddings เหล่านั้นจากอีกอัน Architecture แค่หมายถึงเป็นแบบแผนการออกแบบทั่วไป ไม่ใช่โมเดลเดี่ยว
เมื่อรวมกันแล้ว JEPA จะรับอินพุตสองแบบที่สัมพันธ์กัน มักเป็นสองส่วนของภาพเดียวกัน หรือสองช่วงเวลาของวิดีโอเดียวกัน และเรียนรู้โดยการคาดการณ์ embedding ของส่วนหนึ่งจาก embedding ของอีกส่วนหนึ่ง อย่างสำคัญคือมันไม่พยายามสร้างพิกเซลต้นฉบับขึ้นมาใหม่เลย มันทำงานทั้งหมดในพื้นที่เชิงนามธรรมของการแทน (representations) นี่คือสิ่งที่คนหมายถึงเมื่อบอกว่า JEPA คาดการณ์ใน latent space
มันอยู่ในตระกูลที่เรียกว่า self-supervised learning ซึ่งโมเดลจะสอนตัวเองจากข้อมูลที่ไม่มีป้ายกำกับ โดยซ่อนส่วนหนึ่งของอินพุตแล้วพยายามคาดการณ์จากส่วนที่เหลือ ไม่จำเป็นต้องใช้ป้ายกำกับจากมนุษย์ ใช้แค่ภาพดิบ วิดีโอ หรือสัญญาณอื่นๆ สิ่งที่ทำให้ JEPA แตกต่างจากสมาชิกอื่นๆ ในตระกูลนั้นคือการตัดสินใจที่จะคาดการณ์การแทน (representations) แทนที่จะคาดการณ์ตัวข้อมูลเอง
ทำไมการคาดการณ์พิกเซลถึงเป็นเป้าหมายที่ผิด
เพื่อจะเข้าใจว่าเหตุใด JEPA จึงมีอยู่ ให้ดูสิ่งที่มาก่อนมัน แบบจำลองเชิงสร้าง (generative) จะเรียนรู้โดยพยายามทำซ้ำข้อมูล ซ่อนส่วนหนึ่งของภาพแล้วให้มันเติมพิกเซลที่หายไปแบบเด๊ะๆ หรือให้ประโยคหนึ่งแล้วขอให้มันให้คำถัดไปที่ตรงเป๊ะ ปัญหาคือโลกเต็มไปด้วยรายละเอียดที่ไม่สามารถคาดการณ์ได้อย่างแม่นยำ
ลองนึกภาพวิดีโอที่ลูกบอลกลิ้งไปทางขอบโต๊ะ คุณคาดการณ์ได้อย่างมั่นใจว่ามันจะตก สิ่งที่คุณคาดการณ์ไม่ได้คือวิธีที่มันกระเด้งแบบแม่นยำ รูปแบบแสงบนพื้นแบบตรงเป๊ะ หรือ ตำแหน่งของฝุ่นแต่ละเม็ดในอากาศ แบบจำลองที่ถูกบังคับให้คาดการณ์พิกเซลจึงต้องทุ่มกำลังไปกับรายละเอียดที่คาดเดาไม่ได้ทั้งหมด ซึ่งทำให้ความสามารถของมันถูกใช้กับสัญญาณรบกวน แทนที่จะใช้กับสิ่งที่สำคัญ นั่นคือลูกบอลตก
คำตอบของ JEPA คือหยุดการคาดการณ์รายละเอียด แทนที่จะพยากรณ์พิกเซลทุกชิ้นของเฟรมถัดไป มันพยากรณ์การแทนเชิงนามธรรมของสิ่งนั้น สรุปสิ่งที่ทำให้มันตกได้ ในขณะเดียวกันก็กำจัดส่วนที่ไม่สามารถรู้ได้ Encoder ได้รับอนุญาตให้ทิ้งข้อมูลที่คาดเดาไม่ได้ ทำให้ปัญหาการคาดการณ์ง่ายขึ้น และคุณลักษณะที่มันเรียนรู้ยิ่งมีความหมายมากขึ้น การเปลี่ยนเพียงครั้งเดียว จากการคาดการณ์ข้อมูล ไปสู่การคาดการณ์การแทน คือหัวใจของ JEPA
JEPA ในฐานะโมเดลเชิงพลังงาน
LeCun วาง JEPA ไว้ในแนวคิดที่กว้างกว่าซึ่งเรียกว่า energy-based model และกรอบมุมนี้อธิบายการออกแบบจำนวนมาก โมเดลเชิงพลังงานไม่ได้ส่งออกความน่าจะเป็นหรือป้ายกำกับโดยตรง แต่จะเรียนรู้ฟังก์ชันพลังงานที่ทำให้ค่าต่ำกับชุดของสิ่งที่เข้ากันได้ และค่าที่สูงกับชุดที่เข้ากันไม่ได้ สำหรับคู่ของอินพุต x และ y พลังงานจะต่ำเมื่อ y เป็นคู่หรือตัวสืบต่อที่เป็นไปได้ของ x และจะสูงเมื่อมันไม่ใช่
ใน JEPA พลังงานนั้นคือความคลาดเคลื่อนของการคาดการณ์ในพื้นที่ embedding นั่นคือระยะห่างระหว่าง embedding เป้าหมายที่คาดการณ์ กับ embedding เป้าหมายจริง เมื่อโมเดลคาดการณ์ได้ดี พลังงานจะต่ำ และคู่ดังกล่าวถูกตัดสินว่าเข้ากัน การฝึกคือการเจาะแอ่งลงในภู